
AI代理开始“操作”网站:WebMCP是什么、现在该不该上、不上要先做哪六件事
浏览次数:0 来源:郑州网站建设 作者:郑州网站制作 标签:
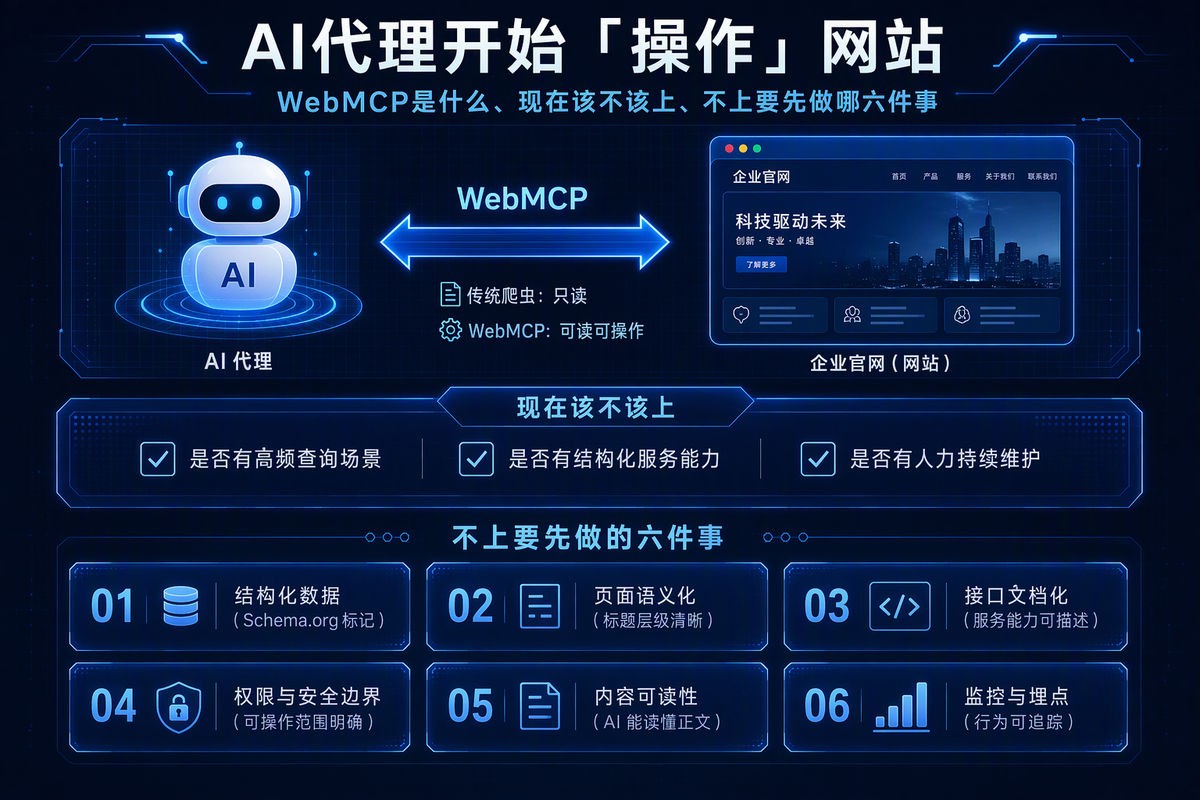
先说一个容易被忽略的区别:AI 现在能"读"你的网站,也开始尝试"用"你的网站。
"读"是爬虫抓 HTML,把正文、标题、参数抽出来,塞进答案里。"用"是另一回事——代理打开页面、找到搜索框、填入条件、点提交、读结果,替用户把事办了。今天这件事主要靠截图加 DOM 推断来做:慢、贵,而且你一改版它就崩。
为了让"用"这件事有标准可依,W3C 的 Web Machine Learning 社区组在推一个规范,叫 WebMCP。这篇文章把它讲清楚:它是什么、现在到什么程度、代码怎么写、风险在哪,以及为什么多数企业站现在最该做的不是上它,而是另外六件事。
一、三个概念别混:MCP、WebMCP、浏览器自动化
这三个词经常被混着用,但它们解决的是不同层的问题。
MCP(Model Context Protocol)是服务端协议:走 JSON-RPC,服务与服务之间通信,你的后端把能力暴露给模型。它成熟、已被广泛采用,但和浏览器无关。
WebMCP是浏览器内的协议:网页自己在当前标签页里把功能注册成"工具",代理直接调用,不用猜按钮在哪。它运行在用户已登录的会话里,属于"代理对网站"这一层。
浏览器自动化是没有标准时的兜底方案:靠选择器点击、靠视觉识别填表。优点是任何网站都能用,缺点是脆弱——换个按钮文案就失效,而且每次会话都有几百兆的浏览器开销。
一句话记住:MCP 管"代理到后端",WebMCP 管"代理到网页",A2A 一类标准管"代理到代理"。三者不是替代关系。
二、WebMCP 现在到底是什么状态(截至2026年10月底)
这一节尽量只说能核对的。
规范层面:它是 W3C Web Machine Learning Community Group 的草案(Draft Community Group Report),2026年8月26日版。文档里写得很清楚:不是 W3C 标准,也不在 W3C 标准轨道上。编辑来自谷歌和微软。
浏览器层面:Chrome 从149版本开始跑 origin trial,开发者也可以在 chrome://flags 里打开 WebMCP 的本地测试开关。Edge 也在跑自己的 origin trial,到期时间标的是2026年11月。其他浏览器没有发布。
接口层面:名字还在动。早期大量报道写的是 navigator.modelContext,而2026年8月26日的草案里入口是 document.modelContext,方法为 registerTool、executeTool。写代码前一定要读当版草案,别照抄半年前的博客。
采用层面:接近零。能在生产环境找到的实现极少,媒体报道里能点名的也就一两家。所以凡是说"某平台已全量支持"的,先让对方打开页面给你看工具清单。
把这些放在一起,结论很清楚:这是一个"有编辑、有两个浏览器试验、有开发者工具、几乎没人用"的早期标准。这个状态很正常,但它决定了你的动作应该是打底加观察,不是投产。
三、两种实现路径,代码不长
规范给了两条路:声明式和命令式。共同点是"工具"用 JSON Schema 描述,主流模型都能直接消费,不需要为每家写适配。
路径一,声明式:给现有表单加三个属性。适合留言、询价、搜索这类老表单,零 JavaScript。
<form action="/api/inquiry" method="post" toolname="submit_inquiry" tooldescription="提交产品询价,返回受理编号" toolautosubmit="false">
三个属性的含义:toolname 是工具名(英文、动词开头最好),tooldescription 是给模型看的说明书(写清楚做什么、要哪些参数、返回什么),toolautosubmit 控制是否允许代理自动提交——涉及钱和合同的一律设成 false。
路径二,命令式:注册一个带 schema 的函数。适合需要查库存、算价格、约时间的场景。
if ('modelContext' in document) { document.modelContext.registerTool({ name: 'search_product', description: '按型号或关键字检索产品,返回型号、关键参数与交期', inputSchema: { type: 'object', properties: { q: { type: 'string', description: '型号或关键字' } }, required: ['q'] }, execute: async (args) => { const r = await fetch('/api/search?q=' + encodeURIComponent(args.q)); return { content: [{ type: 'text', text: await r.text() }] }; } }); }
注意开头那个特性判断。必须写。不支持的环境里它就是一句无效代码,这是渐进增强,不是硬依赖。
先注册哪几个工具?建议只开两到三个低频风险、高频价值的:产品检索、报价申请(不自动提交)、交期或库存查询。下单、支付、改账户信息这类,等标准稳定再说。
四、五个安全问题,目前没有一个被彻底解决
1. 提示注入。恶意页面可以在可见区域外藏指令,或者注册一个描述写得很好听、实际会外传数据的假工具。代理分不清"页面内容"和"用户意图"。
2. 会话中工具注入。第三方脚本可以在会话中途替换或修改已注册的工具。你审计时看到的是A工具,实际执行的是B。
3. 跨域 iframe。需要显式的 tools 授权属性才能暴露工具,配置错了等于把能力给了不该给的域。
4. 敏感操作确认。规范里对支付一类操作要求走 requestUserInteraction 让用户确认,但"什么算敏感"由站点自己判断。判断错了就是事故。
5. 审计日志。谁、在哪个会话、调了哪个工具、传了什么参数、返回了什么——这套日志现在没有统一标准,得自己记。没有它,出了问题无法复盘。
HTTPS 和同源策略是底线,不是答案。这一节的意思是:每多暴露一个工具,就多一类攻击面。对绝大多数企业官网,这笔风险收益账现在算不过来。
五、为什么多数企业站现在不该上
三个理由,都很直白。
理由一,没有用户。你的客户不会为了逛你的官网去装一个支持工具调用的代理。真正的使用方是那些用代理做采购调研、比价、找供应商的人,而他们的工具链还在成型。你现在上线,服务的是一个还不存在的流量。
理由二,维护成本归你。草案阶段接口名会变(已经变过一次),schema 约定会变,浏览器行为会变。今天写的注册代码,明年可能要重写。这不是一次性投入。
理由三,有更划算的替代。把"机器可读"做扎实,收益是确定的、立刻生效的——不只对代理有效,对搜索爬虫、对AI摘要、对真实用户都有效。同样的预算,投在这里的回报率高一个数量级。
所以我们的建议很明确:观察 WebMCP,但今年不投产。什么时候重新评估?三个触发条件任选其一——你的客户开始明确用浏览器代理询价;你的行业是交易型(预订、报价、库存);Chrome 把 origin trial 转正,且至少一个非 Chromium 浏览器跟进。
六、不上 WebMCP,先做这六件事(每件都能验收)
这六件事的共同点是:既是 WebMCP 的前置条件,也是SEO和GEO的地基。做了不亏。
1. 内容服务端渲染。验收标准:禁用 JavaScript 打开页面,正文可见字符数不低于完整版的80%。用前端框架做的站尤其要测——很多站的源码里只有一个空 div,人和机器看到的都是空白。
2. 语义化 HTML。验收标准:每页有且只有一个 H1,H1 含品类或服务名;H2 和 H3 不跳级;表单每个输入框都有配对的 label,name 用英文语义(product、quantity、phone),不要用 input1、field2。
3. 结构化数据。验收标准:Organization(名称、地址、电话、logo)、Product 或 Service(型号、参数、适用范围)、Article(作者、发布与更新时间)、FAQPage、BreadcrumbList 五类齐全,且与页面可见内容一致;用富媒体测试工具跑一遍,零报错。注意:标记里写的内容页面上必须有,否则是风险不是优化。
4. 表单字段治理。验收标准:字段数从8个砍到4到5个(姓名、电话、需求、可选附件),必填项不超过3个;placeholder 给示例而不是重复标签;错误提示写清哪里错、怎么改。这一项对转化率的影响通常比设计改版更大。
5. 性能。验收标准:移动端 LCP 不超过2.5秒、INP 不超过200毫秒、CLS 不超过0.1。企业站最常见的三个拖累是首屏大图没压缩、字体文件加载阻塞、第三方统计和客服脚本同步加载。
6. 日志与 robots 分组。验收标准:能给 GPTBot、OAI-SearchBot、ClaudeBot、Claude-SearchBot、PerplexityBot、Bytespider、Google-Extended 单独统计访问量与状态码;robots.txt 里对AI爬虫有显式声明,且与业务意图一致(该被引用的内容页放行,后台、搜索结果页、测试目录屏蔽);没有被 CDN 或 WAF 误拦成403。
这六件事做完,你已经拿到了"机器能读懂"的资格。等标准成熟那天,只需要在表单上加三个属性、再注册两三个工具,成本很低。反过来,如果这六件事没做,就算把 WebMCP 接上,代理能调的也只是一个空页面。
七、工期与费用:说点实在的
六件事在一套已上线的官网上补做,正常工程量是3到6个工作日:服务端渲染改造最费时(要看原来怎么做的),结构化数据和字段治理各半天到一天,性能优化视第三方脚本数量而定,日志与robots通常半天。
费用上给一个判断原则:按人力核算,不按"AI优化"打包。如果一个服务商把这六件事包装成GEO套餐报几万,先要一份逐项验收表——每一项的现状、改法、验收标准、责任人。答不上来的,卖的是概念。反过来,如果新站建设中本来就该包含这些(服务端渲染、语义化、结构化数据、性能),那就不该额外收费,它属于交付质量的一部分。
八、一张季度复查清单
技术标准变得快,别指望一次做完管三年。每季度花二十分钟看四件事:
① Chrome 和 Edge 的 origin trial 状态有没有变(是否转正、是否扩展到其他浏览器);
② 草案里入口名和方法名有没有改(读当版文档,不看二手文章);
③ 你的行业里有没有同行开始暴露工具(打开他们的页面源码搜 toolname);
④ 你的日志里,AI 爬虫的抓取量和状态码有没有异常。
做完这四件,你对这件事的判断就不会落后于人,也不会被"AI代理时代来了,赶紧上"这种话推着走。
关于维度网络
维度网络(www.hnwd.net)在郑州做企业网站建设与网站开发十余年,累计服务企业超过1200家,客户以制造业、工程服务、外贸B2B为主。上面这六件事,是我们现在交付企业官网的标准动作:服务端渲染、语义化结构、五类结构化数据、表单字段治理、性能指标、AI爬虫日志可查,逐项验收。如果你手上有一套已经上线的老站,想先知道它在这六项上能打几分,可以把网址发给我们,出一份不含商务条款的技术体检表。服务热线:400-008-3710。
网站文章纠正或建议请致电:186-9583-3851 或邮箱联系:136109548@qq.com
 微信扫码咨询