
结构化数据写了三年没效果?Organization、Product、FAQ 三套 JSON-LD 的写法与12项核查清单
浏览次数:0 来源:郑州网站建设 作者:郑州网站制作 标签:
先讲两个真实故障,都发生在这半年。
故障一:一家做工业泵的企业,8 月调价,产品页的价格全部改了,但三年前写的那段 JSON-LD 结构化数据没动。结果 10 月客户拿着 AI 的截图来问:"你们到底是 8600 还是 12800?"截图里,AI 报的是 8600——它读的是结构化数据里的旧价。
故障二:一家外贸公司,结构化数据写得很全,但用前端框架在页面加载后才注入。我们抓了一次初始 HTML,里面一个 application/ld+json 都没有。爬虫看到的是一个空壳。
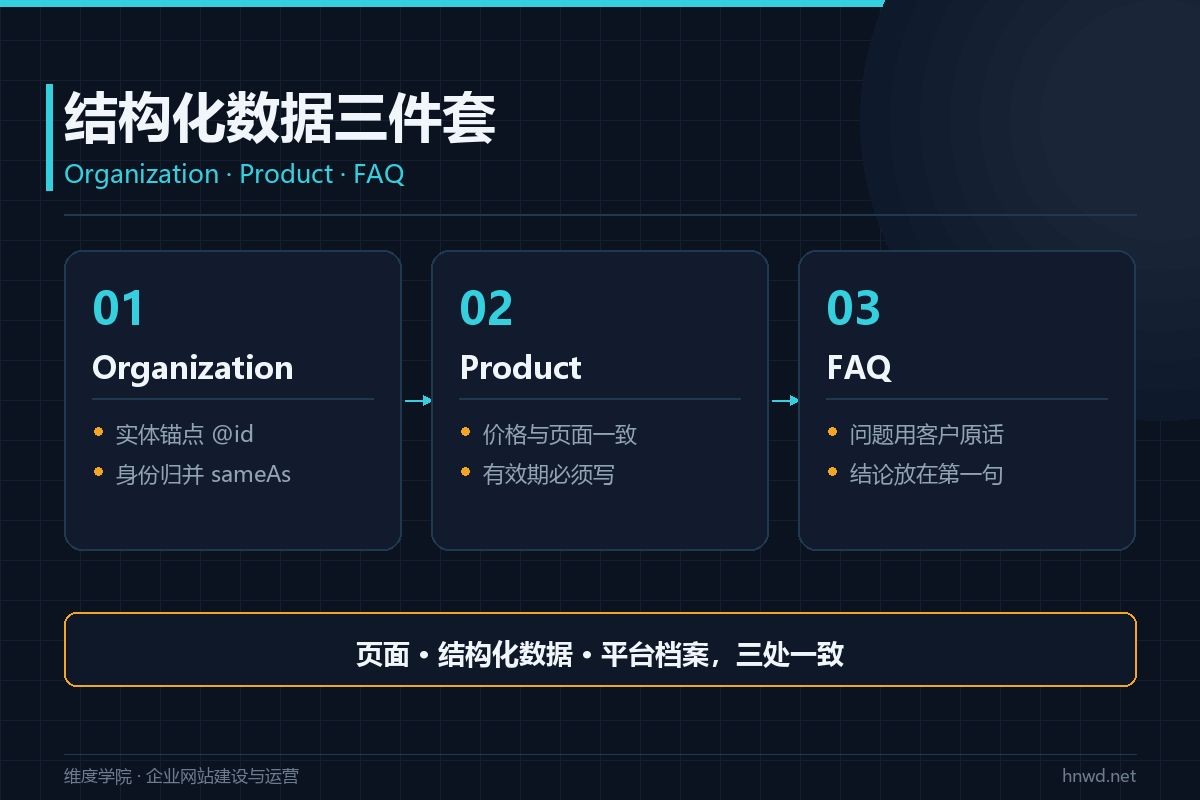
这两个故障指向同一个事实:结构化数据不是"写了就行",它是"要对得上、要被看得见"。企业网站建设里最容易被跳过的一步,恰好就是这一步——把散落在正文、图片、销售话术里的事实,变成机器能直接读的字段。这篇把三套最常用的 JSON-LD(Organization、Product、FAQ)拆开讲,包括字段、代码、最常见的七个错,以及上线前的 12 项核查清单。
一、先看两个数字:为什么现在要重写一遍
AthenaHQ 在 2026 年 9 月发布的《State of AI Search 2026》,统计了八个主流大模型、数百万条回答,得出两个结论:品牌自家域名在 84% 的 AI 答案里没有被引用;平均品牌只在本品类 16.3% 的答案里被提到,品类头部是 56.5%。
另一份是 Kumar 等 2026 年 6 月的研究(10 万+ 条回答、100+ 品牌):全部引用中约 78% 落在企业官网,排名类榜单是最常被引用的格式(21%)。
这两组数字合起来读:官网是被引用最多的来源类型,但绝大多数单个品牌还没进候选池。结构化数据解决的是"进池之后,能不能被正确读懂"这一段——它不负责让你被收录,但负责让模型少说错话。
还有一个背景:Pew 研究中心 2025 年 3 月追踪了 900 名美国成年人的 68879 次谷歌搜索,其中 12593 次出现 AI 摘要;只有 1% 的访问最终点进了被引用的来源。所以别指望结构化数据带来点击,它带来的是"被正确描述"的概率。
二、AI 从你的页面里到底取什么
拆成四个取用点,比记一百个字段有用:
取用点一:初始 HTML。服务端直出的内容才算数。JS 渲染出来的正文、价格、结构化数据,抓取端经常读不到。
取用点二:语义块。一个 <h3> 加下面 2 到 4 段,构成一个可以独立成立的"答案单元"。段落越像"结论 + 依据 + 边界",越容易被整段摘走。
取用点三:结构化字段。把散落在正文里的事实(名称、地址、电话、价格、库存、起订量)变成机器能直接读的键值对。
取用点四:一致性。页面可见文本、结构化数据、平台档案(店铺、地图、商家资料)三处必须一致。任何一处不同,模型就会犹豫;犹豫的结果通常是——不引用你。
三、Organization:最小可用的一套(8 个字段)
放在首页 <head> 或 <body> 末尾,全站只需要一份。
<script type="application/ld+json">
{
  "@context": "https://schema.org",
  "@type": "Organization",
  "@id": "https://www.example.com/#org",
  "name": "某某机械有限公司",
  "alternateName": "某某机械",
  "url": "https://www.example.com",
  "logo": "https://www.example.com/static/logo.png",
  "foundingDate": "2012-05",
  "telephone": "+86-371-88888888",
  "address": {
    "@type": "PostalAddress",
    "streetAddress": "某某路 88 号",
    "addressLocality": "郑州",
    "addressRegion": "河南",
    "postalCode": "450000",
    "addressCountry": "CN"
  },
  "sameAs": [
    "https://www.tianyancha.com/company/xxxx",
    "https://weibo.com/xxxx"
  ]
}
</script>八个字段里,最容易漏的是 @id 和 sameAs。前者的作用是让后面所有的 Product、Article 都能引用同一个实体,不至于一个页面里出现三个"某某机械";后者是给模型做身份归并的抓手——天眼查、企查查、公众号、视频号,把能对上的链接都写上,模型才敢确认"这几条信息说的是同一家公司"。
名称务必和营业执照一致。alternateName 放客户平时叫你的简称。这一条看着琐碎,但它是 84% 那个数字的直接原因之一:模型在第三方看到的是简称,在你官网看到的是全称,对不上,就不引用。
四、Product + Offer:报价型网站怎么写
工业品和消费品写法不同。工业品重点在"参数 + 起订量 + 交期",消费品重点在"价格 + 库存 + 评价"。
<script type="application/ld+json">
{
  "@context": "https://schema.org",
  "@type": "Product",
  "name": "不锈钢离心泵 ISG80-160",
  "sku": "ISG80-160",
  "brand": { "@type": "Brand", "name": "某某" },
  "image": ["https://www.example.com/static/p1-1200.jpg"],
  "description": "流量 50m³/h,扬程 32m,功率 11kW,适用于清水及弱腐蚀性介质。",
  "additionalProperty": [
    { "@type": "PropertyValue", "name": "最小起订量", "value": "1 台" },
    { "@type": "PropertyValue", "name": "交货期", "value": "现货 3 天,定制 15 天" },
    { "@type": "PropertyValue", "name": "材质", "value": "304 不锈钢" }
  ],
  "offers": {
    "@type": "Offer",
    "price": "8600",
    "priceCurrency": "CNY",
    "priceValidUntil": "2026-12-31",
    "availability": "https://schema.org/InStock",
    "url": "https://www.example.com/product/isg80-160.html",
    "seller": { "@id": "https://www.example.com/#org" }
  }
}
</script>
三个要点:
一是 priceValidUntil。报价型网站最怕"报了个去年的价",写上有效期,过期自动失效,比事后解释便宜得多。
二是 additionalProperty。起订量、交期、材质、适用工况,这些都塞进 additionalProperty,不要硬编造成 schema 里不存在的字段。模型读得懂键值对,读不懂你的自定义标签。
三是 seller 用 @id 指回 Organization。这一步把"产品"和"公司"绑成一条实体链,是让 AI 在回答"这家公司做什么"时能一次带出产品的前提。
另外提醒一句:aggregateRating 不要凭空写。没有真实评价就别写,一旦被判定为虚假标记,代价远大于收益。
五、FAQ 与 Article:还能不能用
FAQ 的富结果展示,谷歌从 2023 年起就大幅收紧,只对权威的政府和医疗站点开放。但这不等于 FAQ 没用了——富结果没了,抽取还在。模型依然喜欢问答结构,因为它天然是"问题—答案"的配对。
写法上有两个要点:① 问题用客户的原话,不要用"关于我司产品性能之说明"这种标题;② 答案第一句就给结论,后面再补依据。一条答案控制在 100 字上下,超过 200 字,被整段摘走的概率会下降。
Article(或 BlogPosting)主要给内容页用,四个字段必须准:headline、datePublished、dateModified、author。dateModified 尤其重要——它是模型判断"这条信息还新不新"的主要依据。很多企业三年没改过页面,却把 dateModified 写成今年,这种小聪明一旦被交叉核对,伤的是整站可信度。
六、七个最常见的错,逐条给改法
错一:价格不一致。页面 8600,结构化数据 9200,平台店铺 8800。改法:把价格做成一个变量,三处同一个来源。做不到就用 priceValidUntil 兜底,别让旧价长期挂着。
错二:JS 注入。初始 HTML 里没有 ld+json。改法:服务端渲染或模板直出,用 curl 抓一次源码确认。
错三:@id 断链。Product 里的 seller.@id 指向的地址,首页根本没定义。改法:全站统一一个 @id 规则(域名 + #org),首页必须定义。
错四:图片缺尺寸。image 只写文件名或相对路径。改法:绝对 URL,宽高不低于 1200×800,格式用 JPG 或 WebP。
错五:多语言混写。中文页面塞英文 description,或者反过来。改法:按语言分页面,每个页面标 inLanguage,并配 hreflang。
错六:把导航、页脚也标成 Product。模板复用时最容易犯。改法:结构化数据按页面类型输出,列表页用 ItemList,详情页才用 Product。
错七:一次性写完就不管。改价、换型号、下线产品都不更新。改法:把结构化数据纳入内容更新流程,和改正文同一个动作。网站SEO优化做了很多年的人会发现,这跟当年做 NAP 一致性(名称、地址、电话三处统一)是同一个道理,只是字段变多了。
七、上线前的 12 项核查清单
1)curl 抓初始 HTML,确认 ld+json 存在;2)JSON 能被解析(逗号、引号别错);3)Organization 有 @id、name、url、logo、address、telephone;4)sameAs 至少 2 条可访问链接;5)Product 的 name、image、offers 齐全;6)price 与页面显示一致;7)priceCurrency 为 CNY(或目标市场币种);8)availability 用标准枚举值;9)priceValidUntil 未过期;10)seller.@id 能对上首页;11)dateModified 真实;12)三处信息(页面、结构化数据、平台档案)逐字核对一遍。
工具不用多:Schema Markup Validator 查语法,Rich Results Test 查可解析性,再用 curl 查服务端直出。三个工具十分钟能跑完。在郑州网站建设的交付现场,我们通常把这张清单放在验收表的最后一页,逐项打勾——因为它出错的方式太隐蔽:页面看着完全正常,只有机器读的时候才发现对不上。
一份完整的网站建设方案,也应该把结构化数据写进验收项,而不是当成"技术加分项"。加分项的意思是可做可不做,验收项的意思是不过就得改。
八、多久见效,怎么量
说句实话:结构化数据不会让排名一夜上涨,也不会让 AI 立刻引用你。它的作用是降低误读率——让 AI 说你的价格、型号、地址时,错得少一点。
可测的指标有三个:① 抽 10 个核心问题问 3 个 AI,记录"参数错误率",每月一次;② 看搜索后台的品牌词点击率有没有变化;③ 看询盘里"你们是不是 XX 价"这类纠错型问题有没有减少。三个指标里,第三个最灵敏,通常 4 到 8 周能看到变化。
如果三处信息本来就乱,先别急着写结构化数据——先把事实统一,再谈标记。顺序反了,等于把错误写进机器能读的地方,传播得更快。
关于维度网络
结构化数据、TDK、站点地图、301 映射这些"看不见的活",一直在我们的交付清单里,而不是加钱项。维度网络做企业网站 12 年,累计服务 1200 余家企业,可以提供一次免费的 JSON-LD 体检:抓初始 HTML、跑一遍校验、把三处不一致的地方列成表给你。官网 www.hnwd.net,服务热线 400-008-3710。
网站文章纠正或建议请致电:186-9583-3851 或邮箱联系:136109548@qq.com
 微信扫码咨询